ИИ по 1С без игровой видеокарты
· Команда one-s-mcp · 3 мин чтения
Содержание
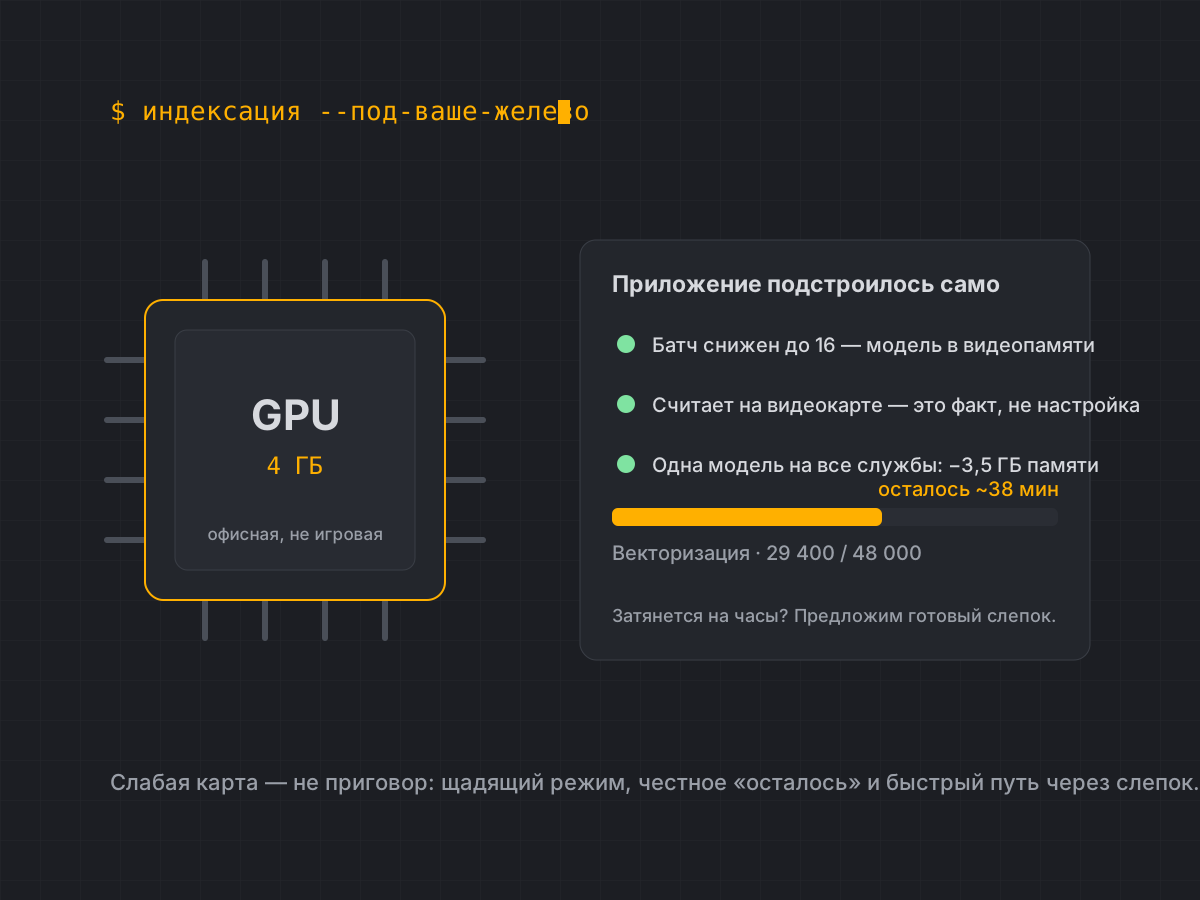
Самая тяжёлая операция нашего продукта — векторизация: каждая процедура и объект конфигурации превращаются в векторы нейросетевой моделью на видеокарте. На мощной карте большая конфигурация индексируется за часы. Но у большинства разработчиков 1С не игровые станции: офисный компьютер с картой на 4 ГБ видеопамяти — обычное дело. Раньше такие карты попадали в невидимую ловушку. Теперь приложение обходит её само.
Ловушка, о которой не сообщает Windows
Если модель с рабочим батчем не помещается в видеопамять, ошибки не будет. Windows тихо вытесняет часть данных в обычную оперативку, и каждый расчёт начинает ходить через медленную шину. Внешне всё «работает на GPU» — а на деле в разы медленнее.
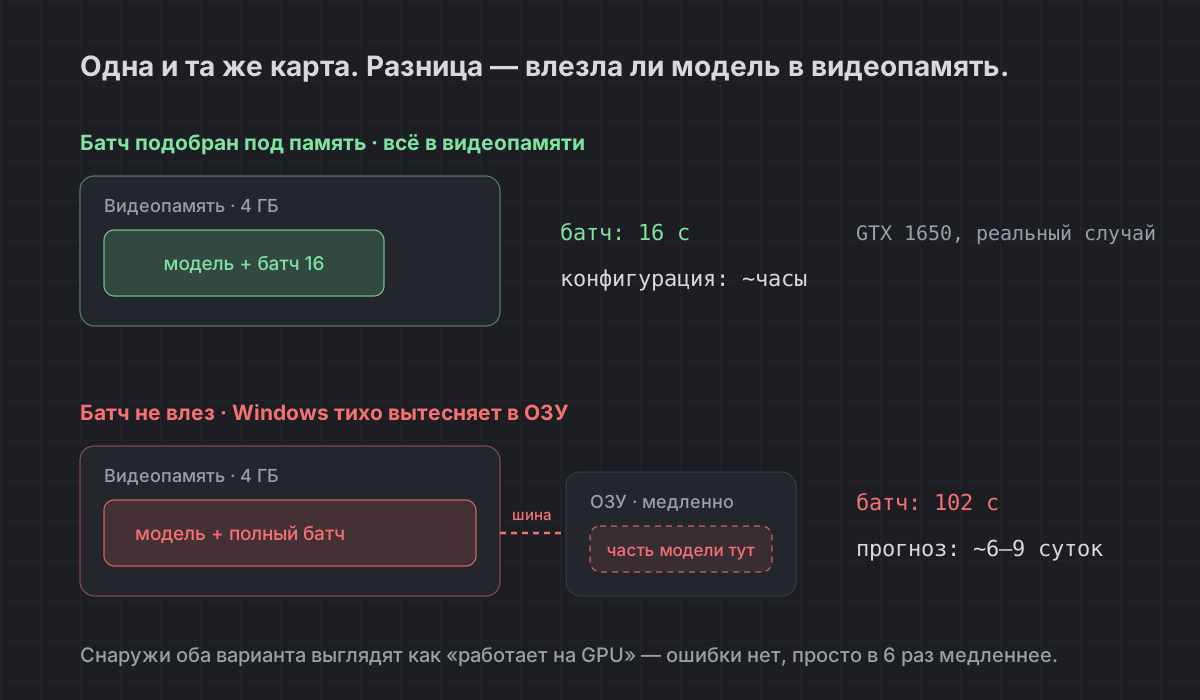
Это не теория: на реальной GTX 1650 мы разобрали случай, когда из-за вытеснения батч замедлился с 16 до 102 секунд, а прогноз индексации вырос с часов до 6–9 суток. Снаружи — никакого сигнала: просто «долго».
Что приложение теперь делает само
Приложение узнаёт у драйвера объём видеопамяти и на слабых картах снижает размер батча векторизации — так, чтобы модель оставалась в быстрой памяти. Слабая карта по-прежнему считает медленнее мощной, но честно на видеокарте — без тихой деградации, превращающей часы в сутки.
У долгих шагов индексации появилась оценка «осталось ~40 минут» — по реальному темпу вашей машины за последние минуты, а не по формуле. Можно планировать: оставить на обед, на ночь — или передумать. А если оценка векторизации переваливает за час и ваша конфигурация — типовая, для которой есть готовый слепок, приложение прямо в панели индексации предложит скачать его: слепок разворачивается за минуты, и видеокарта для этого не нужна вовсе.
Одна модель вместо четырёх копий
Раньше каждая поисковая служба грузила собственную копию нейросетевой модели — и видеопамять кончалась быстро. Теперь модель одна на всех: она живёт в отдельной службе «Модель поиска», к которой остальные обращаются внутри машины. Экономия — до 3,5 ГБ видеопамяти; на картах 4–6 ГБ это разница между «помещается» и «не помещается».
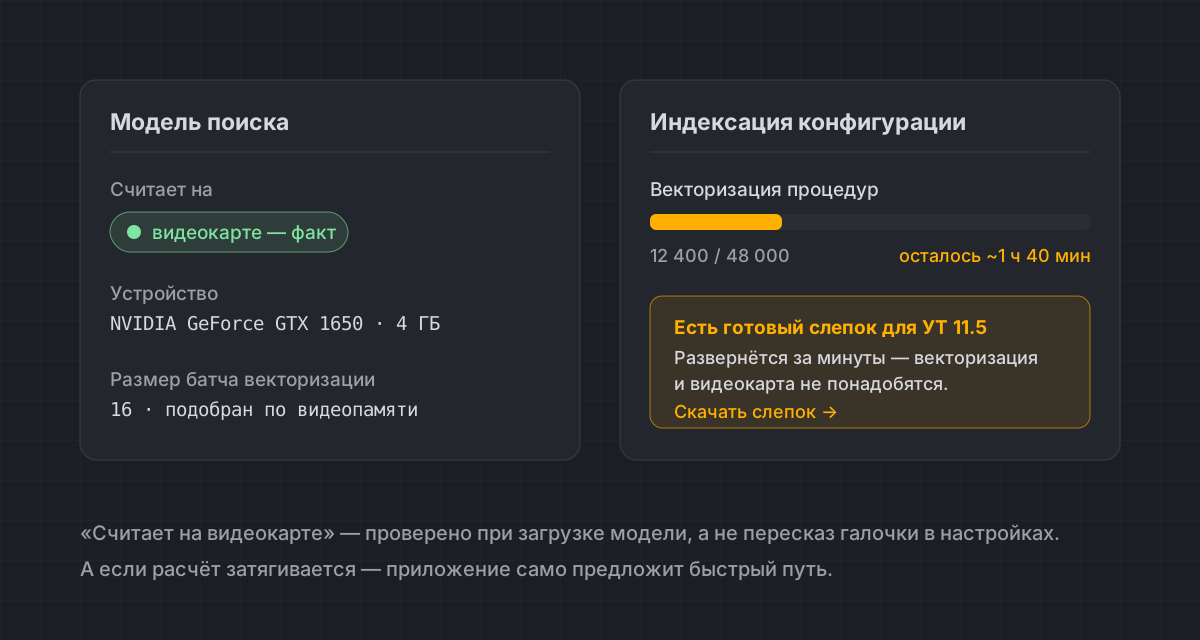
И главное для доверия: в настройках теперь виден факт, а не намерение. «Считает на видеокарте» или «Считает на процессоре» — это проверено при загрузке модели, а не пересказ галочки «GPU включено». Ровно из-за подмены намерения фактом пользователи неделями считали на процессоре, думая, что на видеокарте.
Честно о границах
Автоподбор убирает патологию, но не отменяет физику: карта на 4 ГБ всё равно медленнее топовой — честная формула звучит как «посчитает за разумное время, а для типовых есть слепки», а не «летает на всём». Ступени подбора батча — эвристика по объёму памяти, в крайних случаях остаётся ручная настройка. Объём видеопамяти определяется через драйвер NVIDIA; на других картах и на процессоре автоподбор просто не вмешивается. Оценка «осталось ~N» — оценка: если видеокарту параллельно занимают другие приложения, она может плавать. И для прозрачности: механизм закреплён автотестами и разобранным реальным случаем, а массовую обкатку на слабых картах мы продолжаем — если что-то поведёт себя иначе, напишите нам.